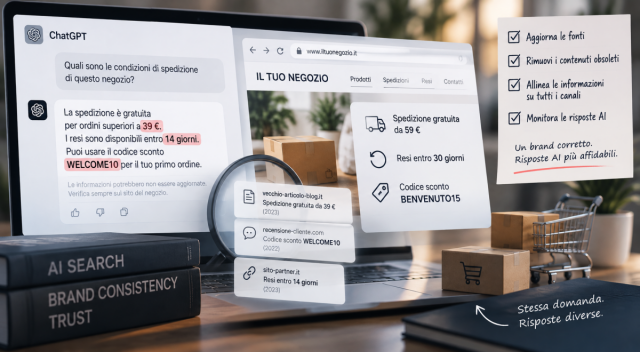
Le informazioni sbagliate nelle risposte AI su un ecommerce dipendono, nella maggior parte dei casi, dal numero di versioni delle stesse informazioni rimaste online, più che da una carenza di contenuti. Quando ChatGPT, AI Mode o Gemini rispondono che la spedizione è gratuita sopra i 39 euro mentre la soglia è salita a 59, o suggeriscono un codice sconto scaduto da due Black Friday, di rado hanno inventato qualcosa. Hanno recuperato una versione del negozio che è stata vera, che da qualche parte è ancora pubblicata e che coincide con le parole della domanda meglio della versione attuale.
È la tesi di Carolyn Shelby, fondatrice della società di consulenza CSHEL Search Strategies, nell’articolo Your Biggest AI Search Risk Is Conflicting Information About Your Brand pubblicato su Search Engine Journal il 7 settembre 2026. Shelby ragiona sui fatti aziendali in generale, con l’esempio di un CEO che non esiste più, e il suo pezzo merita una lettura attenta perché descrive un meccanismo che nella ricerca tradizionale non aveva conseguenze. Per chi vende online il ragionamento vale con un’aggravante: un negozio cambia prezzi, soglie di spedizione, finestre di reso e promozioni nel giro di settimane, e ogni cambiamento lascia in circolazione una versione precedente che un motore può recuperare.
Qui ricostruisco il ragionamento di Shelby per intero, poi lo verifico su un negozio online, dove una risposta vecchia produce effetti al checkout e non solo sul posizionamento. Ogni dato rimanda alla sua fonte, raccolta anche in coda.
Cosa dice l’articolo di Carolyn Shelby su Search Engine Journal
L’argomento centrale è che la visibilità nelle risposte AI non è un problema di produzione di contenuti, e che le informazioni errate su un brand non si correggono pubblicando altre pagine. Shelby lo scrive con una punta di ironia: aggiungere FAQ e contenuti di confronto, o spiegare il prodotto “un’altra volta, ma con sentimento”, non serve, perché il difetto non sta nella quantità di materiale a disposizione dei motori.
Perché il problema è l’eccesso di versioni
Un brand ha già troppe versioni della verità online, e quella che risponde meglio alla domanda dell’utente spesso non è quella corrente. Shelby elenca i casi tipici. Il sito dice una cosa e un vecchio PDF ne dice un’altra. La documentazione di prodotto usa un lessico che il marketing ha abbandonato due anni prima, le biografie dei dirigenti conservano titoli che non esistono più, le pagine dei partner descrivono funzioni nel frattempo cambiate. Non tutte queste affermazioni sono false. Molte erano esatte quando sono state pubblicate e semplicemente non descrivono più l’azienda di oggi.
La ricerca tradizionale conviveva senza troppi danni con questa stratificazione, perché Google poteva posizionare più pagine insieme e lasciare all’utente il compito di capire quale fosse aggiornata. Un motore generativo recupera le fonti e le usa per costruire una sola risposta, che appare definitiva anche quando le prove sottostanti sono in conflitto. Per questo, secondo Shelby, si tratta di un problema di retrieval e di governance dei contenuti, che l’AI search ha reso anche un problema SEO.
Il prompt decide quale versione della verità viene recuperata
Quando una persona fa una domanda a un LLM, il prompt fornisce la cornice e buona parte del vocabolario con cui il sistema cerca le informazioni di supporto. Il sistema può riformulare un po’ la domanda o lanciare più ricerche collegate, ma sta comunque cercando di rispondere alla domanda che gli è stata posta. Il guaio nasce quando la domanda contiene un presupposto superato di cui l’utente non è consapevole.
L’esempio scelto da Shelby è la domanda “chi è il CEO di [azienda]”. Chi la pone dà per scontato che l’azienda abbia ancora un CEO. Non sa che dopo un’acquisizione la guida è passata a un “SVP e general manager” all’interno di un gruppo, e non ha motivo di usare quel titolo. Una ricerca centrata sul nome dell’azienda e sulla parola CEO premia le pagine che contengono esattamente quella relazione, cioè vecchie biografie, comunicati stampa, interviste, profili di conferenze. La pagina attuale del team usa un lessico diverso e può non entrare nemmeno nell’insieme dei documenti recuperati, e un LLM non può citare una fonte che non ha recuperato. La risposta vecchia prevale semplicemente perché usa le stesse parole della domanda.
Un caso reale con quattro ex CEO
Shelby racconta un caso seguito di persona, senza fare il nome dell’azienda. Alla domanda su chi sia l’attuale CEO, un LLM poteva rispondere con uno qualsiasi di quattro ex dirigenti. Nessuna delle risposte era inventata. Tutti e quattro avevano avuto quel titolo, e sia l’azienda sia la capogruppo mantengono pagine storiche che documentano quei ruoli. L’organizzazione attuale usa nomi del tutto diversi per le posizioni di vertice, e per giunta il record pubblico non è coerente, perché il profilo del leader in carica riporta il titolo nuovo nell’intestazione ma lo chiama ancora CEO in qualche testo introduttivo.
Se una situazione del genere è difficile da seguire per una persona, osserva Shelby, per un modello è quasi impossibile. Il prompt stesso porta con sé un modello organizzativo obsoleto, e finché una fonte corrente non collega in modo esplicito la vecchia domanda alla nuova struttura, il retrieval continuerà a restituire il vecchio vocabolario e le persone che vi sono associate.
La correzione: una frase che risponde alla vecchia domanda
L’istinto sarebbe pubblicare una nuova pagina della leadership e aspettare che la correzione arrivi nelle risposte. A volte aiuta, ma pubblicare non equivale a correggere, e un’informazione esatta scritta nel vocabolario sbagliato resta invisibile alla domanda che le persone fanno davvero. Serve quello che Shelby chiama bridge content, contenuto ponte, vale a dire una frase che collega il linguaggio superato alla realtà presente.
Nell’esempio, la frase da pubblicare non si limita a dire che Jane Smith è SVP e general manager. Spiega che dopo l’acquisizione l’azienda non ha più un CEO autonomo e che Jane Smith la guida oggi come SVP e general manager all’interno del gruppo. In quella formulazione ci sono il vecchio ruolo, la ragione per cui non esiste più e il titolo che lo ha sostituito. Il sistema di retrieval trova così una fonte che corrisponde alla parola CEO senza che il titolo venga attribuito a qualcuno che non lo ha. Shelby estende il principio ai prodotti rinominati, ai piani ritirati, alle fusioni, alle certificazioni scadute, alle aree di servizio modificate e alle funzioni spostate in un altro pacchetto. Non si può dare per scontato che l’utente conosca il nuovo nome abbastanza da cercarlo, quindi va pubblicata la relazione tra il termine che usa ancora e la realtà che lo ha sostituito.
Correggere la catena delle prove, non solo la pagina più recente
Una volta individuata una risposta inesatta, il lavoro consiste nel risalire alle citazioni e ai risultati di ricerca che la sostengono, per trovare la catena di prove che la produce invece di seppellirla sotto una pagina nuova. Le pagine di proprietà si possono aggiornare, consolidare, reindirizzare o annotare. Un vecchio annuncio non va riscritto per fingere che la storia sia andata diversamente, ma può portare una data chiara, una nota di stato e un link all’informazione corrente. Le biografie in carica non dovrebbero conservare titoli obsoleti nei testi introduttivi, e i PDF o i materiali di vendita che non rappresentano più l’azienda si ritirano o si etichettano come archivio.
Le fonti terze richiedono più giudizio. Nessuno può pretendere che una testata riscriva un articolo esatto di cinque anni prima perché l’azienda è cambiata dopo. Si può però rendere facile da trovare la spiegazione canonica corrente e chiedere a partner, directory e profili che dovrebbero restare aggiornati di correggere i propri record. A volte, scrive Shelby, la strategia di contenuto più forte è sistemare i vecchi contenuti che ci si era dimenticati di aver pubblicato.
Dal brand visibility audit al brand claim audit
Un inventario dei contenuti classico registra URL, titoli, traffico, posizionamenti e magari conversioni. Un brand claim audit registra le affermazioni fattuali che quei contenuti fanno e, per l’AI search, anche il linguaggio che le persone usano quando chiedono di quei fatti. Per ogni affermazione importante Shelby propone di documentare la domanda o il prompt probabile con il presupposto superato che contiene, la vecchia terminologia accanto all’equivalente attuale, il fatto corrente approvato con la sua fonte pubblica canonica. Nel registro entrano anche gli altri luoghi di proprietà in cui sopravvivono versioni precedenti, le fonti citate oggi nelle risposte AI inesatte, l’azione richiesta (aggiornare, annotare, consolidare, reindirizzare, ritirare o creare contenuto ponte) e il team responsabile di mantenere l’affermazione nel tempo.
L’audit non si ferma alle pagine HTML. Shelby raccomanda di cercare anche nei media kit, nei materiali di vendita scaricabili, nell’help center, nei valori dello schema markup, nei feed di prodotto, nelle schede degli app store, nelle biografie da speaker, negli annunci di lavoro e nei vecchi sottodomini. Vendite, supporto, risorse umane, prodotto, legale e comunicazione andrebbero interpellati su cosa pubblicano senza passare dal team web. L’obiettivo non è rendere identica ogni frase ovunque, dato che pubblici diversi hanno bisogno di livelli di dettaglio diversi. I fatti di fondo devono però risolversi nella stessa risposta, e il linguaggio che le persone usano ancora deve condurle alla spiegazione corrente invece di intrappolare il retrieval nel passato.
Misurare l’accuratezza, non la presenza
I report di visibilità AI tendono a misurare se un brand è stato menzionato, citato o incluso per un insieme di prompt. Sono osservazioni utili, ma la presenza da sola crea una falsa sicurezza. Per i prompt di maggior valore Shelby propone di valutare la risposta in sé, verificando se è esatta, se è aggiornata e se risponde all’intento reale dell’utente invece di accettare la premessa falsa contenuta nella domanda. Quando la risposta è sbagliata si ispezionano le citazioni e si riproducono le ricerche probabili prima di concludere che il modello abbia allucinato.
Una menzione non è una vittoria se la risposta nomina un ex dirigente, usa un vecchio prezzo, attribuisce al prodotto attuale una funzione dismessa o fraintende il rapporto tra brand e capogruppo. Nessuno controlla ogni frase pubblicata su un brand, ma si può fare in modo che le domande che le persone fanno davvero abbiano un percorso chiaro verso la verità corrente. Shelby ammette che questo lavoro non produrrà mai il grafico celebrativo delle 200 pagine pubblicate nel trimestre. Renderà il brand più facile da capire per i motori, per i sistemi AI, per i clienti e per i giornalisti, e nella ricerca generativa quella chiarezza fa parte della visibilità.
Perché per un ecommerce il problema pesa di più
Per un negozio online le versioni della verità sono più numerose che per un’azienda B2B e invecchiano molto più in fretta. Shelby parte da un fatto che cambia ogni qualche anno, il nome di chi guida l’azienda. Un ecommerce modifica la soglia di spedizione gratuita, la finestra di reso, i metodi di pagamento, i nomi delle linee e i prezzi con cadenza di settimane, e ogni modifica lascia dietro di sé una fonte che era vera. Il cliente, poi, scopre il conflitto tra le versioni nel momento meno adatto, quando è in cassa con un’aspettativa formata altrove.
Le prime versioni stanno in casa: schede prodotto, condizioni di vendita, FAQ, blog, listini PDF per i rivenditori, comunicati stampa, pagina “chi siamo”. A queste si aggiungono i feed, da Merchant Center al feed prodotto per ChatGPT fino ai comparatori di prezzo, che di rado vengono aggiornati con la stessa frequenza delle pagine. I marketplace portano un altro strato, perché una scheda Amazon scritta da un reseller può usare il vecchio nome della linea o proporre un bundle che il brand non vende più. Il territorio meno controllabile resta quello delle terze parti. Siti di coupon che tengono vivo il codice del Black Friday 2024, una risposta del supporto su Trustpilot che nel 2023 citava i 30 giorni di reso. Oppure una recensione affiliata con la vecchia soglia di spedizione e la scheda Google Business Profile con orari e sedi non aggiornati.
Le domande con cui i clienti interrogano ChatGPT o AI Mode hanno la stessa struttura del “chi è il CEO” di Shelby. Chi chiede “X fa la spedizione gratuita?” ha in mente una soglia, e il modello andrà a cercarne una, probabilmente quella del post più citato. Una richiesta come “codice sconto X settembre 2026” convoglia il retrieval verso gli aggregatori di coupon, che rispondono con codici scaduti perché nessuna pagina del brand dichiara quali codici siano validi oggi. Lo stesso schema si ripresenta con i nomi di linea, dove la domanda “che differenza c’è tra X Classic e X Heritage” tratta come coesistenti due nomi di cui uno è il vecchio nome dell’altro. Per l’origine produttiva, “X è ancora made in Italy?” recupera la pagina aziendale scritta prima dello spostamento di una parte della produzione. In tutti questi casi la risposta arriva sicura e il cliente se la porta fino al carrello, o fino alla chat del servizio clienti. La differenza rispetto a un errore di posizionamento è che qui il danno si misura in vendite perse e in ticket di assistenza, e un’AI Overview con un prezzo sbagliato ne produce entrambi.
Google, nel perimetro dello Shopping, applica da anni la logica che le risposte AI estendono all’intero web. Quando il prezzo nel feed di Merchant Center non coincide con quello della pagina di destinazione, la guida ufficiale di Merchant Center tratta la discrepanza come errore critico che può portare alla sospensione dell’account. In un canale controllato, quindi, due versioni dello stesso prezzo sono già considerate un danno per l’utente. Nelle risposte generative quel controllo manca, e a prevalere è la versione che corrisponde meglio alle parole della domanda.
Cosa dice la ricerca sui conflitti tra fonti
La letteratura scientifica sui knowledge conflicts, i conflitti di conoscenza nei modelli linguistici, conferma che un LLM tende ad adottare l’evidenza ricevuta dal retrieval anche quando è sbagliata, purché sia coerente. Xie, Zhang, Chen, Lou e Su, in uno studio presentato a ICLR 2024, hanno messo i modelli davanti a prove esterne costruite in contrasto con la loro memoria parametrica, cioè con ciò che hanno appreso in addestramento. I risultati vanno in due direzioni. I modelli si mostrano molto ricettivi verso evidenze esterne coerenti e convincenti, anche quando contraddicono ciò che sanno, e allo stesso tempo manifestano un forte bias di conferma quando tra le prove ce n’è una che concorda con la loro memoria. Applicato a un negozio, significa che se le fonti recuperate dicono in coro che la spedizione è gratuita sopra i 39 euro il modello lo ripeterà, e che se ha assorbito quel dato in addestramento tenderà a difenderlo anche davanti a una fonte più recente.
ClashEval, il benchmark di Wu, Wu e Zou pubblicato a NeurIPS 2024, ha misurato la stessa dinamica su oltre 1.200 domande in sei domini, alterando in modo controllato le risposte contenute nei documenti recuperati. Sei modelli di punta, GPT-4o compreso, hanno adottato il contenuto recuperato errato scavalcando la propria conoscenza corretta in oltre il 60% dei casi, con una tendenza tanto più marcata quanto più l’errore era plausibile e quanto meno il modello era sicuro della propria risposta iniziale. Una vecchia soglia di spedizione rientra esattamente nella categoria degli errori plausibili. La survey di Xu e colleghi presentata a EMNLP 2024 classifica questi scenari e ne isola uno che descrive un ecommerce alla lettera, il conflitto inter-contesto, ossia tra documenti recuperati che si contraddicono per rumore, informazioni superate o errori. È il caso della pagina delle condizioni di vendita e del post del blog che dicono cose diverse.
Il riscontro più vicino al tema del brand viene da Clovion AI, società di ricerca di Oslo, il cui studio “Surviving the AI Funnel” è stato esaminato da Greg Jarboe su Search Engine Journal a luglio 2026. Lo studio ha eseguito 69.120 conversazioni multi-turno su Claude, ChatGPT e Gemini in 36 categorie software e fintech. I tre assistenti si contraddicono apertamente sui fatti di brand nel 15% dei casi, con 330 contraddizioni verificate, e la direzione dell’errore cambia da motore a motore, con Gemini che attribuisce ai brand funzionalità in eccesso mentre Claude e ChatGPT tendono a sottostimarle. L’ipotesi di lavoro di Zahir Hasan, COO di Clovion, ancora non pubblicata, è che la differenza dipenda dalle fonti su cui ciascun motore si appoggia, materiale marketing e video per Gemini, documentazione e pagine prodotto per gli altri due. Se l’ipotesi regge, ogni motore starebbe leggendo una versione diversa dello stesso brand. Lo studio ha misurato anche che il 62% dei brand raccomandati nella prima risposta sparisce dopo una sola domanda di follow-up ordinaria, come “per un piccolo team”.
Sui numeri di Clovion serve una cautela in più. La bozza del report riportava 33 contraddizioni al posto di 330 e 204 brand al posto di 2.040 per uno zero perso in impaginazione, corretto dopo le domande di Jarboe. Sono comunque i numeri di un solo studio, condotto su categorie B2B e non sul retail, e vanno letti come tali. Il fenomeno che descrivono coincide però con quanto documentato in altri ambiti. I ricercatori del Tow Center della Columbia University nel marzo 2025 hanno sottoposto 1.600 richieste di citazione a otto motori di ricerca generativi, ottenendo risposte errate in oltre il 60% dei casi. La ricerca coordinata da EBU e BBC nell’ottobre 2025 ha fatto esaminare a giornalisti di 18 paesi oltre 3.000 risposte di ChatGPT, Copilot, Gemini e Perplexity. Il 45% conteneva almeno un problema significativo, il 31% errori di attribuzione delle fonti, il 20% problemi di accuratezza, informazioni superate comprese. Quegli studi riguardano l’informazione giornalistica e non i dati commerciali, ma il meccanismo di recupero e citazione che vi fallisce è lo stesso che seleziona una soglia di spedizione o un prezzo.
Come correggere le informazioni sbagliate nelle risposte AI sul tuo ecommerce
La correzione richiede di lavorare su tre piani insieme, perché ciascuno agisce su una porzione diversa delle fonti che un motore recupera. Si tratta delle frasi pubblicate sulle pagine canoniche, della catena delle fonti che alimenta le risposte sbagliate e dei dati che i motori leggono direttamente, cioè markup e feed.
Scrivere frasi ponte per le condizioni che cambiano
Sulla pagina delle spedizioni la formulazione che serve è “dal 1° marzo 2026 la soglia per la spedizione gratuita è passata da 39 a 59 euro”, e non la semplice “la spedizione è gratuita sopra i 59 euro”. La prima contiene il dato vecchio, che è quello che il cliente ha in testa, la data del cambio e il dato nuovo. Un motore che recupera quella frase può rispondere alla domanda “sopra i 39 euro è gratis?” con un no motivato invece di un sì sbagliato.
Lo stesso schema si applica alla finestra di reso, con una frase come “i resi si accettano entro 30 giorni dalla consegna, fino al 2024 la finestra era di 14 giorni”. Vale per i nomi di linea, con una formula come “la linea Classic si chiama Heritage dal 2025, con le stesse taglie e gli stessi codici prodotto”. Per l’origine produttiva si può scrivere “dal 2025 la maglieria è prodotta in Portogallo, la pelletteria resta a Firenze”, e la stessa logica copre i metodi di pagamento e i rapporti societari dopo un’acquisizione. Per i codici sconto il ponte più solido è una pagina canonica “Promozioni e codici sconto attivi”, con data di aggiornamento visibile, che dichiari quali codici sono validi e avverta che i codici pubblicati su siti terzi possono essere scaduti. Non fermerà gli aggregatori, ma dà al retrieval una fonte di prima mano che risponde alla domanda che i clienti fanno davvero, con le parole “codice sconto” al suo interno.
Bonificare la catena delle fonti del negozio
Il passo successivo è risalire alle fonti citate nelle risposte sbagliate e intervenire su quelle, invece di limitarsi ad aggiungere una pagina nuova sopra di esse. Il post del blog del 2023 sulla spedizione gratuita non va cancellato. Va datato, annotato con la condizione attuale e collegato alla pagina canonica, oppure reindirizzato se non ha altro valore. Il listino PDF per i rivenditori si toglie dall’indicizzazione o si sostituisce con la versione corrente. Le risposte del supporto su Trustpilot e Google che citano condizioni superate meritano una risposta di aggiornamento nello stesso thread, perché un modello legge anche quelle. Le schede sui marketplace vanno allineate al nome corrente della linea, e partner e affiliati che pubblicano la soglia di spedizione vanno avvisati a ogni cambio, con la stessa disciplina con cui si comunica un cambio di listino.
Rendere la verità leggibile dalle macchine
Dati strutturati e feed sono per i motori la fonte più diretta di prezzi e condizioni, e vanno tenuti allineati a ciò che dicono le pagine. Google documenta i tipi MerchantReturnPolicy per le politiche di reso e ShippingService per le politiche di spedizione a livello di organizzazione, con OfferShippingDetails per le eccezioni sul singolo prodotto. Da novembre 2025, come annunciato sul Search Central Blog, le impostazioni “Spedizione e resi” di Search Console sono disponibili a tutti i siti riconosciuti come merchant anche senza un account Merchant Center, e quando sono configurate prevalgono sul markup. Chi ha Merchant Center ha già lì la sede naturale per soglie e tempi di consegna, a condizione che coincidano con quello che dice la pagina.
Sul fronte ChatGPT, la guida di OpenAI indica che i merchant possono fornire un feed prodotto diretto perché ChatGPT rifletta sempre le informazioni più aggiornate su prezzo e disponibilità. La specifica pubblica prevede campi obbligatori per prezzo e disponibilità e attributi per la logistica, e per i negozi su Shopify i dati del catalogo arrivano già attraverso Shopify Catalog. Il feed diventa così la fonte di riferimento del prezzo e, con protocolli come UCP e ACP di cui ho scritto a proposito della SEO agentica, anche la base su cui gli agenti completano gli acquisti. Se il feed viene aggiornato ogni ora e la pagina delle condizioni è ferma al 2023, il negozio sta pubblicando due versioni della stessa informazione, e non è detto che il motore scelga quella giusta.
Il registro delle affermazioni di un ecommerce
Il brand claim audit di Shelby, applicato a un negozio, diventa un registro delle affermazioni commerciali. Dentro ci vanno prezzo e politica di sconto, soglia e costi di spedizione, tempi di consegna, finestra e costi di reso, garanzia, metodi di pagamento, punti vendita e orari, certificazioni, origine produttiva, proprietà societaria, nomi di linee e prodotti. Per ciascuna voce si annotano la domanda che il cliente pone e il presupposto superato che può contenere, il vecchio termine con l’equivalente attuale e la pagina canonica. Seguono i luoghi in cui sopravvive la versione vecchia, le fonti citate nelle risposte AI sbagliate, l’azione decisa e chi ne risponde. Ha senso che il registro sia in mano a chi gestisce listino e condizioni di vendita, più che alla redazione, perché cambia quando cambia una condizione commerciale e ogni cambio dovrebbe generare un intervento sulle fonti.
Come misurare se le risposte AI sul tuo ecommerce sono corrette
La misurazione va spostata dalla presenza all’accuratezza, prompt per prompt, ed è un passaggio che gli strumenti oggi disponibili non fanno da soli. Il report AI Performance di Search Console, di cui ho scritto a fine agosto, dice quante volte le pagine di un sito compaiono in AI Overviews e AI Mode. Non dice se in quelle risposte il prezzo o la soglia di spedizione sono quelli giusti. Serve un set di 30-50 domande sui fatti commerciali del negozio, formulate come le farebbe un cliente e comprensive dei follow-up reali, del tipo “e per un ordine da 45 euro?” o “vale anche per i resi dall’estero?”. Il set va eseguito su ChatGPT, AI Mode, Gemini e Perplexity, classificando ogni risposta come corretta, obsoleta, errata o assente e annotando le fonti citate. Il 62% di caduta dopo un follow-up misurato da Clovion suggerisce, come scrive Jarboe, che un monitoraggio fermo alla prima risposta osserva la cima di un imbuto che si svuota una frase dopo.
Le risposte generative cambiano da un’esecuzione all’altra, per cui una sola lettura dice poco. Il metodo corretto è campionare, con più esecuzioni per prompt e per motore, calcolare la quota di risposte corrette con il suo intervallo di confidenza e confrontarla nel tempo dopo ogni intervento sulle fonti. È l’impostazione che adottiamo nelle rilevazioni con Prism, ma il principio non dipende dallo strumento. Vale anche qui il consiglio di Jarboe: prima di costruire una strategia su una percentuale, conviene verificare da dove arriva il conteggio.
Domande frequenti sulle informazioni sbagliate nelle risposte AI
Perché ChatGPT dà informazioni sbagliate sulla mia azienda?
Nella maggior parte dei casi perché online esistono più versioni delle stesse informazioni e il modello recupera quella che corrisponde meglio alle parole della domanda, anche se è superata. Vecchi post, PDF, schede sui marketplace, risposte del supporto e siti di coupon restano indicizzati e vengono citati come fonti attuali.
Le AI inventano i dati sul mio negozio?
Raramente. Secondo l’analisi di Carolyn Shelby su Search Engine Journal, il rischio principale non è l’invenzione ma il recupero di affermazioni esatte in passato e oggi obsolete, perché usano il linguaggio con cui le persone fanno la domanda. Il benchmark ClashEval mostra che i modelli adottano contenuti recuperati errati in oltre il 60% dei casi.
Basta pubblicare una pagina aggiornata per correggere l’AI?
No. Una pagina nuova scritta con termini diversi da quelli della domanda può non essere recuperata. Serve una frase ponte che citi il vecchio dato, la data del cambio e il dato attuale, e vanno datate, annotate o ritirate le fonti precedenti che continuano a essere citate nelle risposte.
Come scopro quali fonti cita l’AI sul mio brand?
Ponendo ai motori le domande reali dei clienti e leggendo le citazioni nelle risposte di ChatGPT, AI Mode, Gemini e Perplexity, poi riproducendo le ricerche probabili. Le fonti ricorrenti nelle risposte sbagliate compongono la catena delle prove su cui intervenire, in proprietà o chiedendo l’aggiornamento a partner e directory.
Che cos’è un brand claim audit?
È un inventario delle affermazioni fattuali che i contenuti di un brand fanno, con la domanda che i clienti pongono, il presupposto superato, la fonte canonica, i luoghi in cui sopravvivono versioni vecchie, l’azione da compiere e il responsabile. Per un ecommerce copre prezzi, spedizioni, resi, garanzia, pagamenti, sedi, certificazioni e nomi di prodotto.
Come misuro se le risposte AI sul mio ecommerce sono corrette?
Con un set di domande sui fatti commerciali del negozio, follow-up compresi, eseguito più volte su ogni motore e classificato per risposta corretta, obsoleta, errata o assente, annotando le fonti citate. La quota di risposte corrette, con il suo intervallo di confidenza, va confrontata nel tempo dopo ogni intervento sulle fonti.
Fonti
Carolyn Shelby, Your Biggest AI Search Risk Is Conflicting Information About Your Brand, Search Engine Journal, 7 settembre 2026.
Greg Jarboe, 62% Of AI Brand Recommendations Vanish After One Buyer Question: New Data, Search Engine Journal, 7 luglio 2026.
Jian Xie, Kai Zhang, Jiangjie Chen, Renze Lou, Yu Su, Adaptive Chameleon or Stubborn Sloth: Revealing the Behavior of Large Language Models in Knowledge Conflicts, ICLR 2024.
Kevin Wu, Eric Wu, James Zou, ClashEval: Quantifying the tug-of-war between an LLM’s internal prior and external evidence, NeurIPS 2024, Datasets and Benchmarks Track.
Rongwu Xu, Zehan Qi, Zhijiang Guo, Cunxiang Wang, Hongru Wang, Yue Zhang, Wei Xu, Knowledge Conflicts for LLMs: A Survey, Proceedings of EMNLP 2024, pp. 8541-8565.
Klaudia Jaźwińska, Aisvarya Chandrasekar, AI Search Has a Citation Problem, Columbia Journalism Review, Tow Center for Digital Journalism, 6 marzo 2025.
EBU e BBC, News Integrity in AI Assistants, European Broadcasting Union, ottobre 2025.
Google, More ways to share your shipping and returns policies with Google, Search Central Blog, novembre 2025.
Google, Merchant return policy structured data (MerchantReturnPolicy), Search Central.
Google, Merchant shipping policy structured data (ShippingService), Search Central.
Google, Merchant listing structured data, Search Central.
Google, How to fix: Automatic updates: Mismatched price, Guida di Merchant Center.
OpenAI, Shopping with ChatGPT Search, OpenAI Help Center.
OpenAI, Product Feed Spec, Agentic Commerce, OpenAI Developers.